Gesundheitsdatennutzung
Der Zwilling aus Daten – Zukunftsmedizin für Neugeborene
Praktisch alle Babys werden beim Neugeborenen-Screening kurz nach der Geburt auf angeborene Erkrankungen untersucht. Aus dieser Routine heraus entstand über Jahrzehnte ein einzigartiger Schatz an Daten zur frühkindlichen Entwicklung. Lange blieb er ungenutzt – bis sich Heidelberger Forschende daran machten, einen Digitalen Zwilling für Neugeborene zu entwickeln. Heute steht diese Technologie an der Schwelle zur Anwendung.
Kaum eine medizinische Untersuchung erreicht eine vergleichbare Reichweite: Seit 2005 ist das erweiterte Neugeborenen-Screening (NBS) Kassenleistung, und nahezu jedes Baby in Deutschland wird 36 bis 72 Stunden nach der Geburt untersucht. Für die freiwillige Früherkennungsuntersuchung werden wenige Tropfen Blut abgenommen und im Labor auf bis zu 20 seltene angeborene Erkrankungen untersucht - allesamt gut behandelbar, falls die Therapie früh einsetzt. Ergänzt wird das NBS durch weitere regelmäßige Vorsorgeuntersuchungen – die „U-Untersuchungen“ –, darunter alleine 6 Termine im ersten Lebensjahr. Beide Programme gehören zu den wirksamsten Präventionsmaßnahmen im deutschen Gesundheitssystem.
Das NBS wird dezentral in verschiedenen Geburtskliniken und Laboren durchgeführt. Die Ideen dahinter entstehen an wenigen Zentren. Eines davon ist Heidelberg: Hier hat der Kinderarzt und Stoffwechselexperte Prof. Dr. Georg Friedrich Hoffmann das NBS von Beginn an mitgeprägt. Über Jahrzehnte entstand dabei am dortigen Zentrum für Kinder- und Jugendmedizin des Universitätsklinikums einer der umfangreichsten Screening-Datenbestände Deutschlands – ein Datenschatz von enormem Wert aus vielen Millionen anonymisierten Messwerten.
Digitaler Baby-Zwilling: Früher erkennen, besser vorbeugen
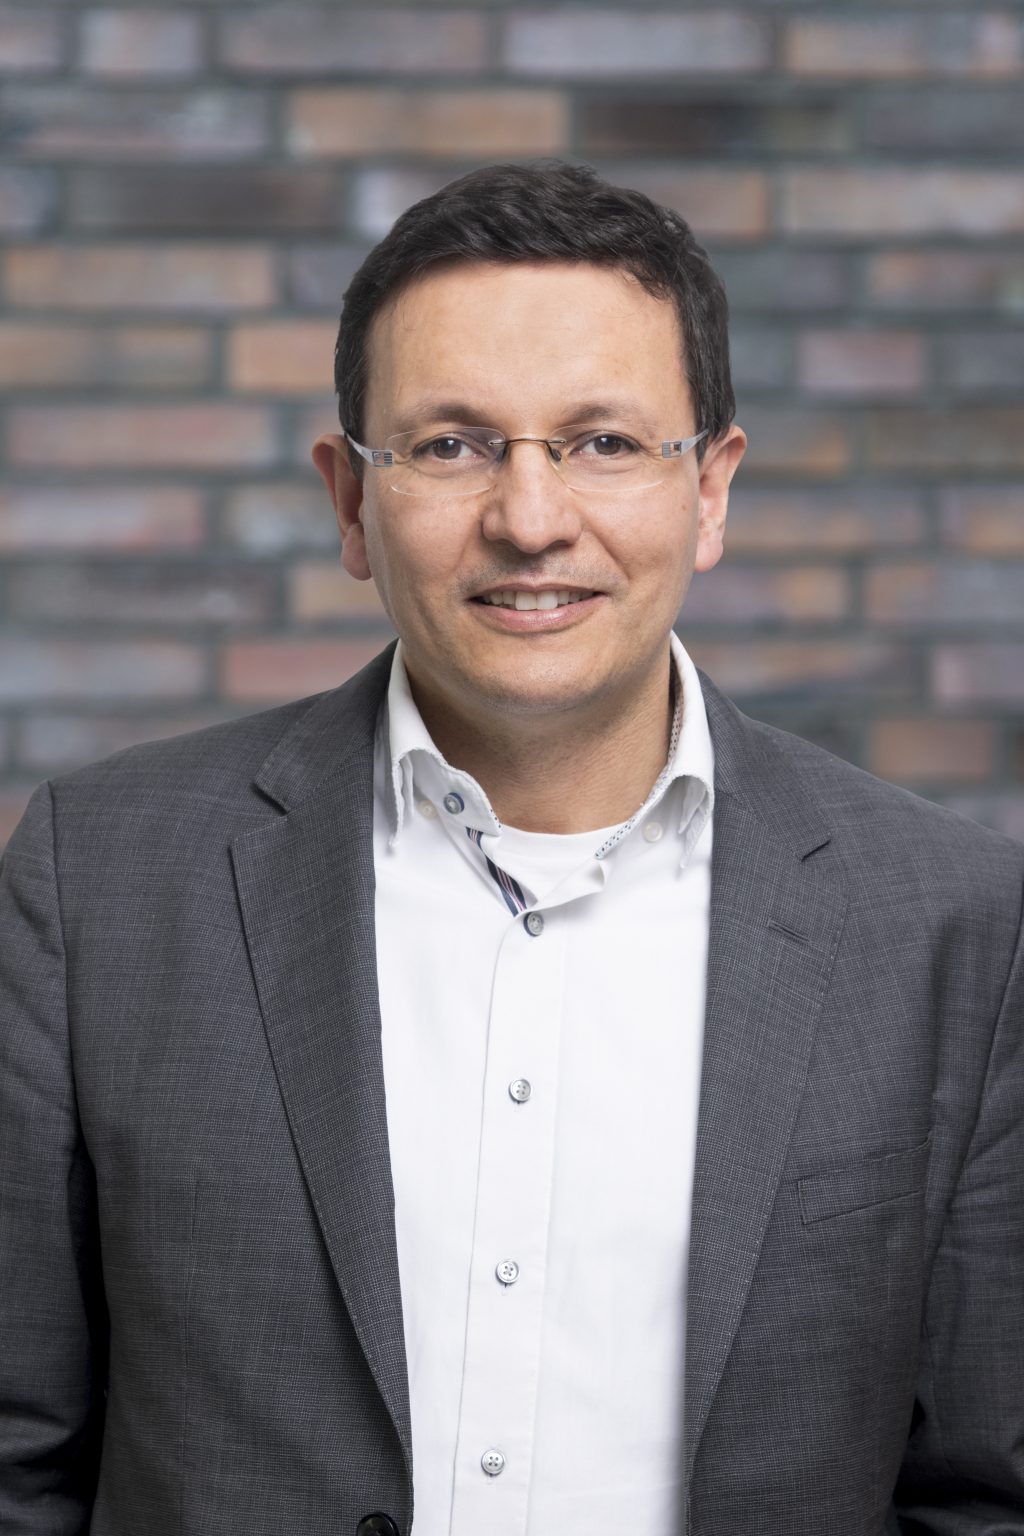 Prof. Dr. Vincent Heuveline ist geschäftsführender Direktor des Rechenzentrums und Chief Information Officer der Universität Heidelberg. Außerdem leitet er zwei Forschungseinheiten: Das Engineering Mathematics and Computing Lab (EMCL) am Interdisziplinären Zentrum für Wissenschaftliches Rechnen (IWR) und die Arbeitsgruppe „Data Mining and Uncertainty Quantification“ am Heidelberger Institut für Theoretische Studien (HITS gGmbH). © HITS gGmbH
„Doch was tun mit den Informationen, die bei den Tests „nebenbei“ entstehen? Wie könnte man Daten und Erfahrungen zusammenführen und Zusammenhänge entwickeln, sodass sie nicht verlorengehen? Könnte KI helfen, wo das menschliche Gehirn an seine Grenzen stößt?“, fragte sich Hoffmann schon vor Jahren und wandte sich mit diesen Fragen an den Kollegen Prof. Dr. Vincent Heuveline. Der Informatiker und Mathematiker ist u. a. Direktor des Heidelberger Universitätsrechenzentrums, Leiter einer Forschungsgruppe am Heidelberger Institut für Theoretische Studien (HITS) und einer der wichtigsten Köpfe für IT, Dateninfrastruktur und digitale Forschung in der Heidelberger Forschung. Eines der Probleme, das die beiden damals erörterten: die sehr kleinen Zahlen an Positivbefunden – auffälligen Neugeborenen –, die in der enormen Datenmenge korrekt zu detektieren sind. „Falsch-positive Befunde müssen unbedingt vermieden werden, die den Familien große Sorgen bereiten. Man muss deshalb äußerst zuverlässig agieren“, so die übereinstimmende Expertenmeinung.
Gesagt – getan: Heuveline machte sich mit einem internationalen Team aus Forschenden des HITS, der Universität Heidelberg und der University of Galway, Irland an die Arbeit, die Daten nutzbar zu machen. Aus Millionen Messwerten des NBS und von U-Untersuchungen der ersten 18 Monate sollten Digitale Zwillinge für Babys entwickelt werden; personalisierte Stoffwechselmodelle, um etwa Krankheitsrisiken und Therapieeffekte vorherzusagen oder medizinische Entscheidungen unterstützen zu können. Mit Erfolg, denn die Forschenden konnten mithilfe ihrer entwickelten mathematischen Modelle erstmals die gesundheitliche Entwicklung der Kinder für deren gesamten Stoffwechsel simulieren. Dabei wurden 26 Organe, sechs Zelltypen und mehr als 80.000 Stoffwechselreaktionen berücksichtigt und mit realen Daten von Neugeborenen personalisiert.1) „Wir können mit Stolz sagen, dass wir mit dem Projekt ein Stück Pionierarbeit geleistet haben, um aus bislang brach liegenden medizinischen Daten sinnvolle Zusammenhänge zu schaffen“, meint Heuveline. „Die große Datenmenge ist ein Glücksfall für KI und numerische Simulationen – eine wichtige und sehr zuverlässige Basis.“
Wenn aus Vermutung Evidenz wird
Wie aber wurden aus den Daten Säuglings-Modelle? Hierfür kamen drei grundlegend unterschiedliche Ansätze zum Einsatz: Ein erster modellbasierter Schritt bildete Stoffwechselwege mathematisch ab. Diese Pathways wurden zunächst von den Biologinnen und Biologen des Teams erstellt, dann in mathematische Modelle übersetzt. „Die größte Herausforderung bestand am Anfang darin, dass Pathways teilweise unvollständig oder gar nicht erfasst waren“, berichtet der Datenexperte. „Für uns als Mathematiker ist es aber wichtig, dass Modelle eine Lösung haben und abgeschlossen sind – nur dann lassen sie sich sinnvoll berechnen, und nur so ist ein Übergang zur Simulation möglich. Diese Wissenslücken zu schließen, war deshalb ein wichtiger Entwicklungsschritt.“
Der aber letztendlich gelang. Sie konnten in silico untersuchen, wie sich verschiedene Parameter auf die Entwicklung der Babys auswirken. „Dabei haben wir sehr viele Zusammenhänge definiert“, sagt Heuveline. „Für uns Mathematiker sind das Zahlen, aber in der Diskussion mit den Medizinern gab es mehrfach Aha-Effekte: Vermutungen wurden plötzlich greifbar.“ So sei ein intensiver Austausch entstanden, in dem die Modelle überprüft wurden. „Die Mathematik erzählte uns hier ein Stück weit die Welt“, meint er. „Und oft zeigte sich tatsächlich: Was lange nur die Vermutung erfahrener Ärztinnen und Ärzte war, ließ sich plötzlich auch belegen.“
KI besteht den Eignungstest
 Für den Digitalen Zwilling für Neugeborene wurde eine riesige Datenmenge aus dem Neugeborenen-Screening verarbeitet und so die gesundheitliche Entwicklung der Kinder für deren gesamten Stoffwechsel simuliert. © KI-generiert | HITS gGmbH
Ein zweiter Ansatz beschäftigte sich mit der Integration von KI, um die enorme Datenmenge zu verarbeiten. Dafür entwickelte und trainierte man KI-Modelle und verknüpfte Messdaten mit klinischen Befunden. Eine besondere Herausforderung wiederum: „Viele Daten von gesunden Babys – glücklicherweise – gegenüber nur wenigen von ungesunden. Das heißt, das System muss in der Lage sein, dies zu berücksichtigen“, sagt Heuveline. Und genau das gelang letzten Endes. Um den Erfolg nachzuweisen, trainierten die Forschenden die Modelle zunächst nur mit einem Teil der Messdaten. Mit dem anderen Teil testeten sie, ob die Vorhersagen des Systems korrekt waren. Und tatsächlich: Daten, zu denen bereits pathologische Befunde vorlagen, wurden zuverlässig erkannt und sofortiges Handeln angemahnt.
Der wunde Punkt des Systems sei bislang aber noch der Black-Box-Charakter der KI, so der Professor: „Wir brauchen Erklärbarkeit – daran arbeiten wir derzeit.“ Dann könne das System zertifiziert und im klinischen Alltag eingesetzt werden. Die Vision: Ärztinnen und Ärzte erhalten nach dem NBS direkt einen Hinweis auf ihrem Tablet – etwa „unbedenklich“ oder „weitere Abklärung erforderlich“. „Das Ergebnis allein reicht jedoch nicht aus. Die KI muss auch nachvollziehbar erklären, wie sie zu ihrer Einschätzung gelangt, sonst ist das zu dünn.“
Prototyp steht in den Startlöchern
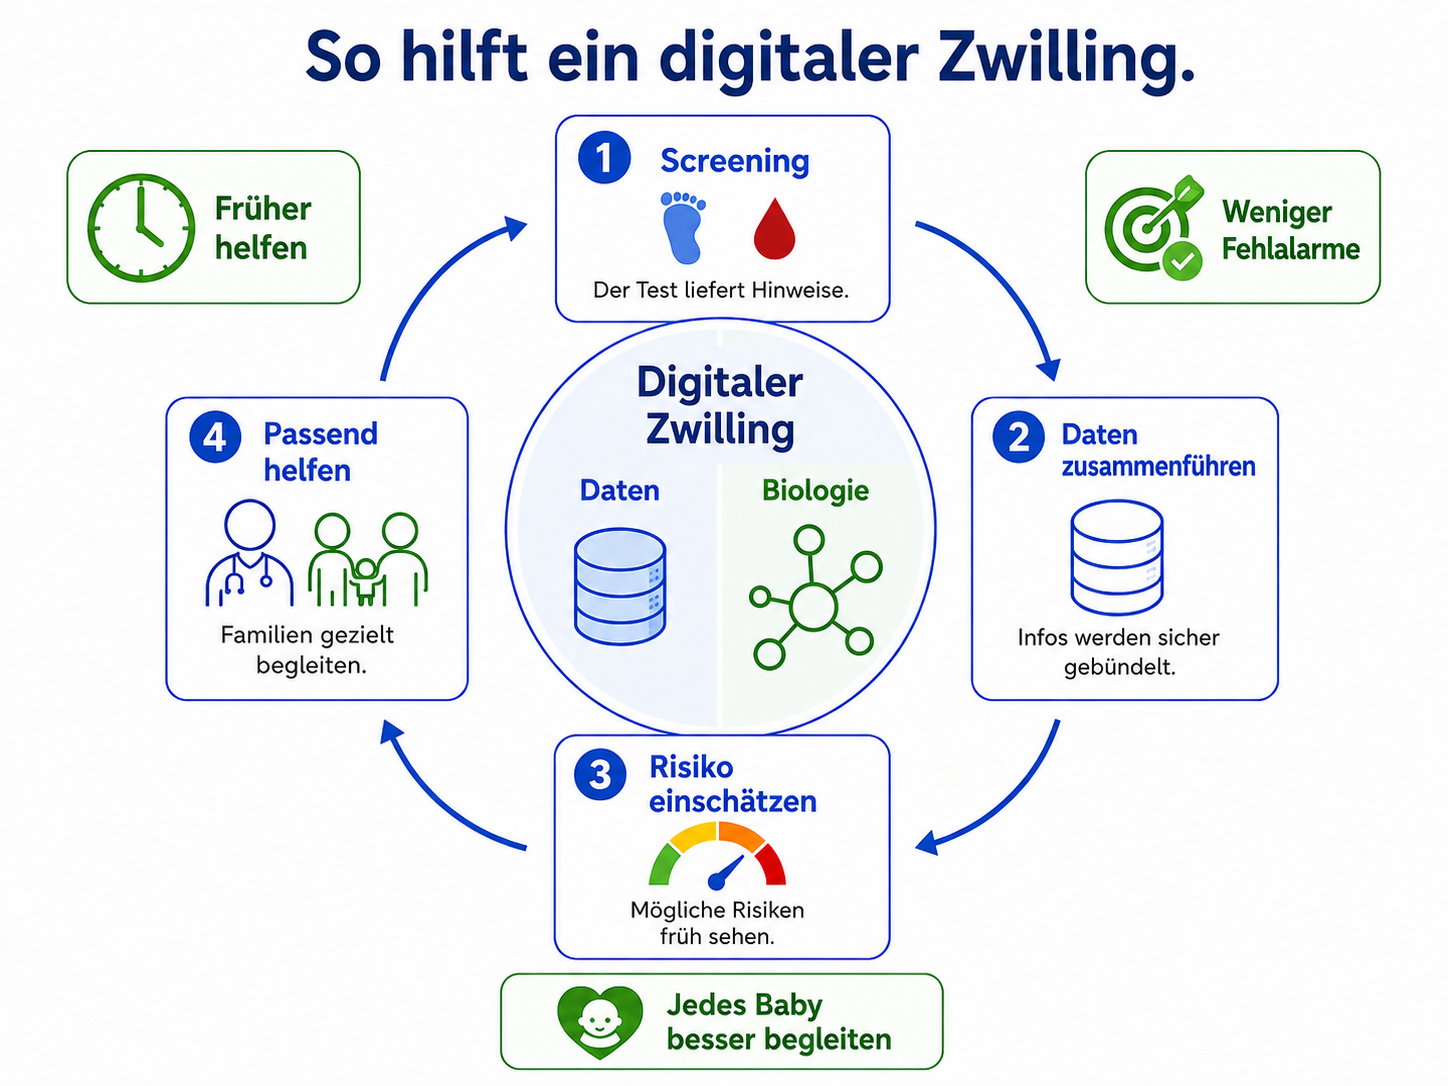 So soll der Digitale Zwilling künftig in der klinischen Anwendung funktionieren: Er soll falsch-positive Befunde reduzieren, Risiken frühzeitig einschätzen und damit einen raschen Therapiebeginn ermöglichen, falls nötig. © KI-generiert | HITS gGmbH
Den dritten Schritt der Forschungsarbeit bildete schließlich die Zusammenführung beider Ansätze. So entstand ein System, das die Stärken zweier Welten vereint: mathematische Modellierung und KI. Die Forschenden wollen das System nun noch auf ein deutlich breiteres Spektrum an Erkrankungen und Befunden ausweiten und außerdem den zeitlichen Ablauf integrieren. Bislang erkennen die Modelle Risiken direkt nach der Geburt. Künftig soll das Zeitfenster größer werden. Mit dem rasanten Wachstum der Babys verändern sich allerdings auch die biologischen Signalwege. Die Modelle müssen daher lernen, diese Dynamik abzubilden. Dadurch würden die Modelle allerdings auch beliebig komplex, sagt er: „Wir kommen mit unseren Rechnern an Grenzen, das explodiert regelrecht. Dafür braucht es dann ein benutzerfreundliches Cloudsystem statt einer Tablet-Anwendung.“
Der Digitale Zwilling steht für einige Anwendungen bereits auf Präprodukt-Niveau. Der größte Schritt zur Praxis ist nun nicht mehr Forschung, sondern Zertifizierung und Markteinführung. „Die Hürden sind nun regulatorischer Natur“, sagt Heuveline. Dafür brauche es Partner: „Wir können die Prototypen entwickeln und validieren – für den Weg zum Produkt sind jedoch andere Expertisen gefragt. Gelingt es, die Fragen der Erklärbarkeit und Regulierung zu lösen, könnte die Technologie schon in kurzer Zeit den Sprung in die klinische Anwendung schaffen.“ Dieser letzte Schritt sei aber generell keine Stärke europäischer Forschungseinrichtungen: „Wir sind gut darin, Prototypen zu bauen, aber der letzte Schritt fehlt leider oft – wie bei einem Marathon. 40 Kilometer sind weit – doch das Rennen ist noch nicht vorbei.“ Eines ist aber schon sicher: Die Heidelberger Forschenden dürften einen entscheidenden Beitrag zum Digitalen Zwilling für Neugeborene geleistet haben – und damit zur Gesundheitsvorsorge von Beginn an.
